免费 · macOS · apple silicon
你会用 AI 做的一切。
全都不离开这台 Mac。
与任意开源模型对话,用 20 个智能体工具写代码,用 Flux 生成和编辑图像,在格式之间转换模型,并向你的其他应用提供 OpenAI 或 Anthropic 兼容的 API。一个应用,全部运行在 Apple Silicon 上。没有 API 密钥,没有订阅,什么都不会被上传。
永久免费 · macOS 14.5+ · M1 至 M5 · 最低 8GB,建议 16GB 以上
MLX Studio — 控制台
智能体工具
20+
文件读写、搜索、shell、git、网页 — 无需配置
模型架构
50+
包含 Mamba 与 SSM 混合架构
01
你需要的一切。云端什么也没有。
简单到打开就能聊天,深入到底层跑着完整的推理栈 — KV 缓存量化、前缀缓存、投机解码和 14 种工具解析器。想用时全都在,不想用时完全看不见。
01
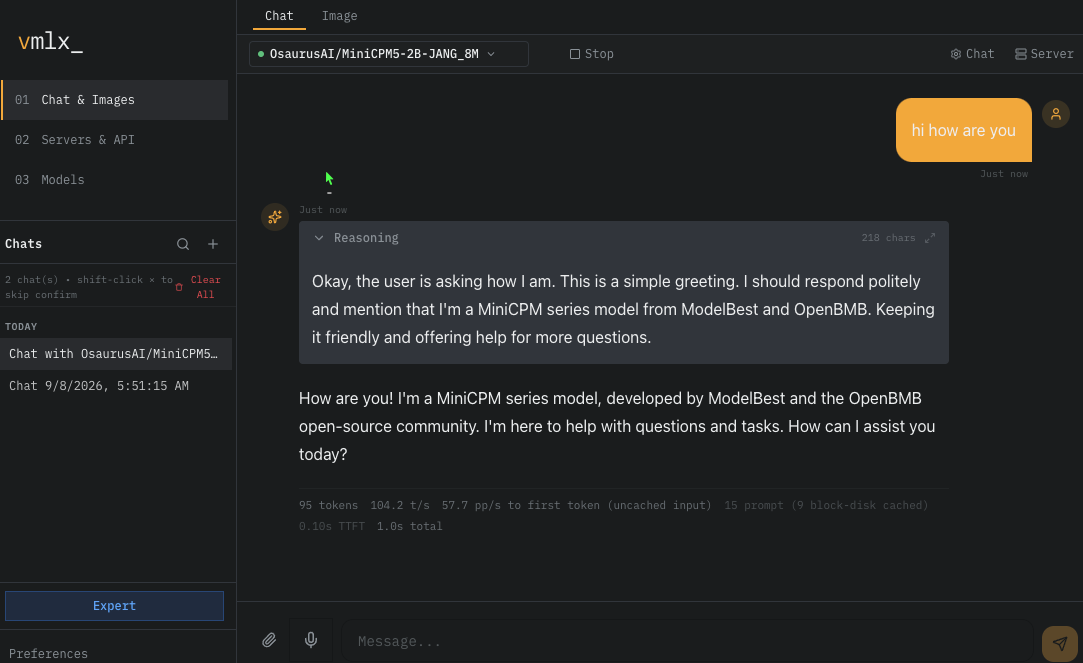
流式聊天多轮对话,带内联工具调用标记、可折叠的推理块、图像预览和实时状态。
任意模型
02
智能体编程20 个内置工具,原生支持 MCP。模型可直接在你的机器上读取、写入、搜索和执行。
20 个工具
03
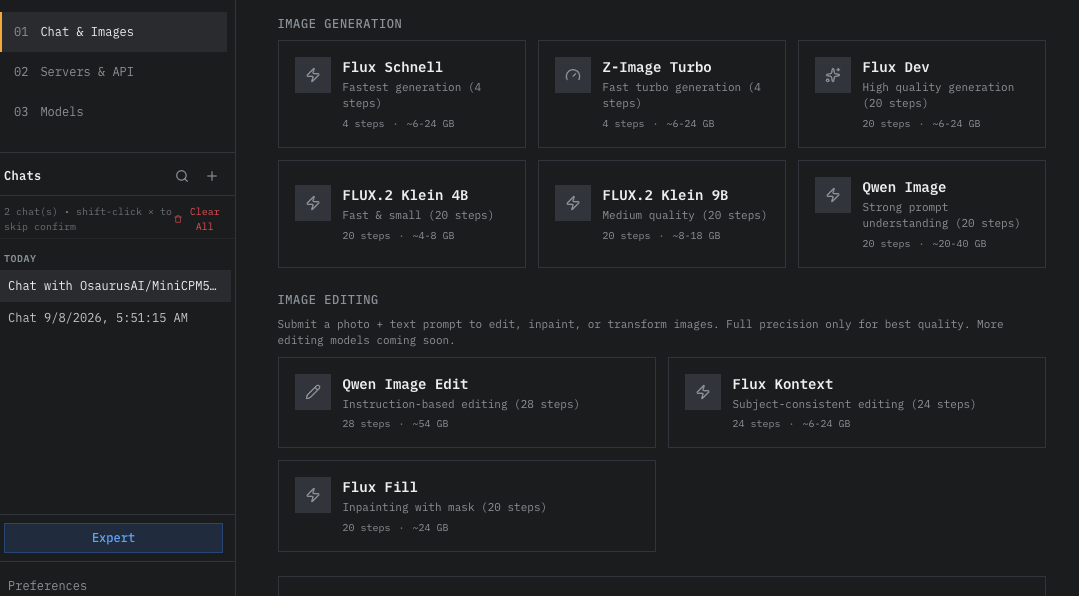
图像生成与编辑生成用 Flux Schnell、Dev 和 Klein;编辑用 Qwen Image Edit、Flux Kontext 和 Flux Fill,支持局部重绘与风格转换。
9 个模型
04
视觉与多模态把图片拖进对话即可。视觉模型在本地分析,点击可放大预览。
qwen vl
05
推理块DeepSeek R1、Qwen 3 和 GLM 的思维链可折叠展示。想看就看,不看就收起。
4 个解析器
06
语音每条回复都可用 Mac 原生语音合成朗读,解放双手。
内置
07
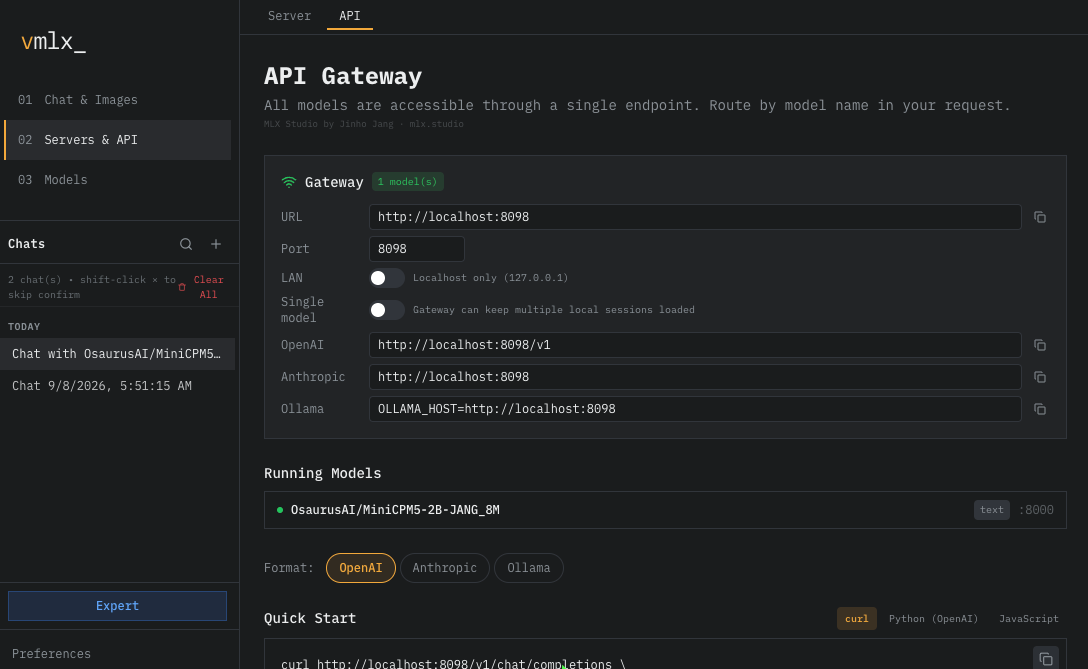
Anthropic 与 OpenAI API在 OpenAI Chat 和 Responses 之外,还提供原生的 Anthropic Messages 端点。Claude Code、OpenClaw 和 Anthropic SDK 无需改动即可连接,也可以指向远程端点。
两者
08
模型转换器应用内完成 GGUF 到 MLX 的转换,还有 JANG 混合精度量化配置。不必等别人发布转换版本。
gguf → mlx
────────────────────────────────────────────────────────────────────────────────────────────────────────
────────────────────────────────────────────────────────────────────────────────────────────────────────
03
在自己的机器上生成和编辑图像
九个模型,按需下载并在 Apple Silicon 上运行。只给提示词,或者给一张照片加提示词来做局部重绘、变换或风格化。无云端 API,无点数消耗。
Flux Schnell
最快生成 · 4 步 · ~6-24 GB
Z-Image Turbo
快速涡轮生成 · 4 步 · ~6-24 GB
Flux Dev
高质量 · 20 步 · ~6-24 GB
FLUX.2 Klein 4B
又快又小 · 20 步 · ~4-8 GB
FLUX.2 Klein 9B
中等质量 · 20 步 · ~8-18 GB
Qwen Image
提示词理解强 · 20 步 · ~20-40 GB
Qwen Image Edit
指令式编辑 · 28 步 · ~54 GB
Flux Kontext
主体一致的编辑 · 24 步 · ~6-24 GB
Flux Fill
带遮罩的局部重绘 · 20 步 · ~24 GB
────────────────────────────────────────────────────────────────────────────────────────────────────────
04
它底下是 vMLX 引擎
MLX Studio 是应用 — 聊天窗口、工具、模型浏览器。vMLX 是驱动它的推理引擎,并且是开源的。这个关系大致相当于 LM Studio 之于 llama.cpp,只不过两边都是我们做的。
01
前缀缓存对话中重复的部分只计算一次并重复使用,所以长对话不会越来越慢。
层 1
02
分页 KV 缓存所有打开的对话都常驻内存 — 来回切换不会淘汰任何内容。
层 2
03
缓存量化q4/q8 把实时缓存内存压缩 4–8 倍,超长上下文才放得下。已存储的前缀保持完整精度。
层 3
04
连续批处理单个已加载模型上最多 256 个并发序列,多个智能体可以共用。
层 4
05
持久磁盘缓存重启应用后提示词的计算结果依然在,回来就是热启动而不是冷启动。
层 5
首个 token 时间 — M3 Ultra 256GB · Llama 3.2 3B 4-bit · 对比 LM Studio
| 上下文 | MLX Studio | LM Studio | 差距 |
|---|
| 2.5K tokens短提示 | 0.05 s | 0.49 s | 9.7× |
| 10K tokens实际工作上下文 | 0.08 s | 6.12 s | 76× |
| 100K tokens冷提示处理 | 0.65 s | 131 s | 224× |
在 M3 Ultra 256GB、Llama 3.2 3B 4-bit 上对比 LM Studio 测得。前两行是首个 token 时间,最后一行是冷提示处理。解码吞吐是另一项指标,取决于上下文长度和输出的可预测性,因此这里不用单一数字表示。
────────────────────────────────────────────────────────────────────────────────────────────────────────
05
它长什么样
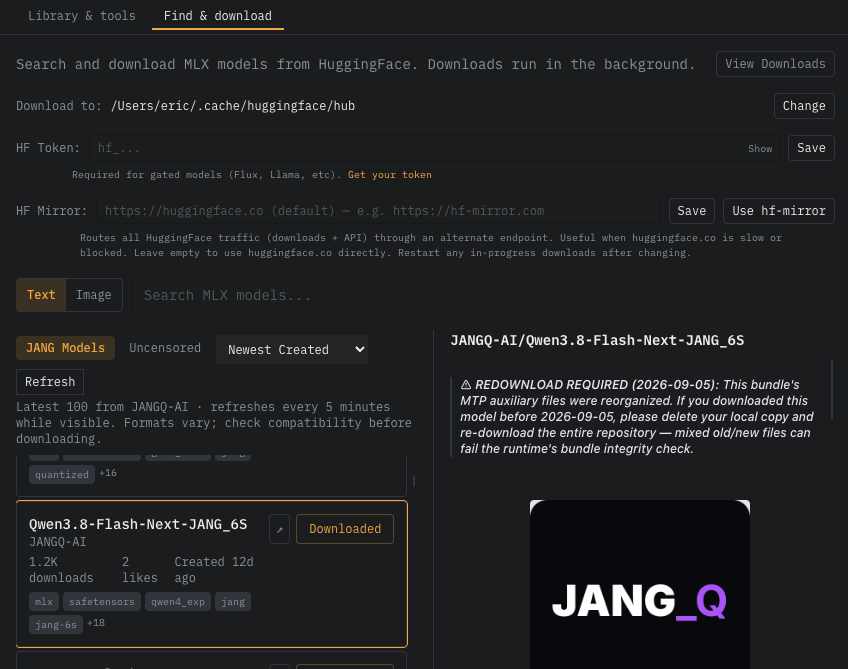
应用在 Apple Silicon 上运行时的界面。
聊天与图像
模型 — 搜索与下载
服务器与 API — 网关
────────────────────────────────────────────────────────────────────────────────────────────────────────
06
获取
下载应用,或者只装引擎——如果你只需要那个服务端。
应用推荐
# 下载后拖到「应用程序」并打开
# 聊天、工具、图像、转换器和
# API 服务端,全在一个应用里
引擎pip
$ pip install vmlx
$ vmlx serve mlx-community/Qwen3-8B-4bit
# 兼容 OpenAI 与 Anthropic
# http://127.0.0.1:8000
────────────────────────────────────────────────────────────────────────────────────────────────────────
07
常见问题
MLX Studio 是什么?
一款免费的 macOS 应用,用于 AI 聊天和智能体编程,模型在 Apple Silicon 上本地运行。它包含 20 个内置工具,可用于文件编辑、代码搜索、shell 执行和网页搜索,还有图像生成与编辑、模型转换器和 API 服务端,底层由 vMLX 引擎驱动。
MLX Studio 和 vMLX 引擎有什么区别?
MLX Studio 是应用 — 聊天界面、智能体工具、模型浏览器和设置。vMLX 是驱动它的推理后端:缓存、批处理、模型加载和 API 层。大致相当于 LM Studio 之于 llama.cpp,只是两边属于同一个项目。引擎是开源的,可以用 pip install vmlx 单独安装。
需要联网吗?
只有第一次下载模型时需要。所有推理都在本地运行,没有云端连接,没有 API 密钥,数据不会离开你的 Mac。
需要什么样的 Mac?
任何 M1 及以上的 Apple Silicon Mac,系统为 macOS 14.5 或更新。统一内存最低 8GB,16GB 以上更从容。连接远程端点在 macOS 14+ 上可用。
可以同时用云端 API 吗?
可以。你能连接 OpenAI、Anthropic、Groq 或任何 OpenAI 兼容端点。无论模型在本地还是远程,智能体工具的行为完全一致。
多少钱?
免费。永久免费,没有订阅、账号或付费档位。