무료 · macOS · apple silicon

AI로 하던 모든 일.
맥을 벗어나지 않습니다.

어떤 오픈 모델과도 대화하고, 20개 에이전틱 도구로 코드를 쓰고, Flux로 이미지를 만들고 편집하고, 모델 포맷을 변환하고, 다른 앱에 OpenAI·Anthropic 호환 API를 제공합니다. 앱 하나로, 전부 Apple Silicon 위에서. API 키도 구독도 없고, 업로드되는 것도 없습니다.
영구 무료 · macOS 14.5+ · M1~M5 · 최소 8GB, 16GB 이상 권장

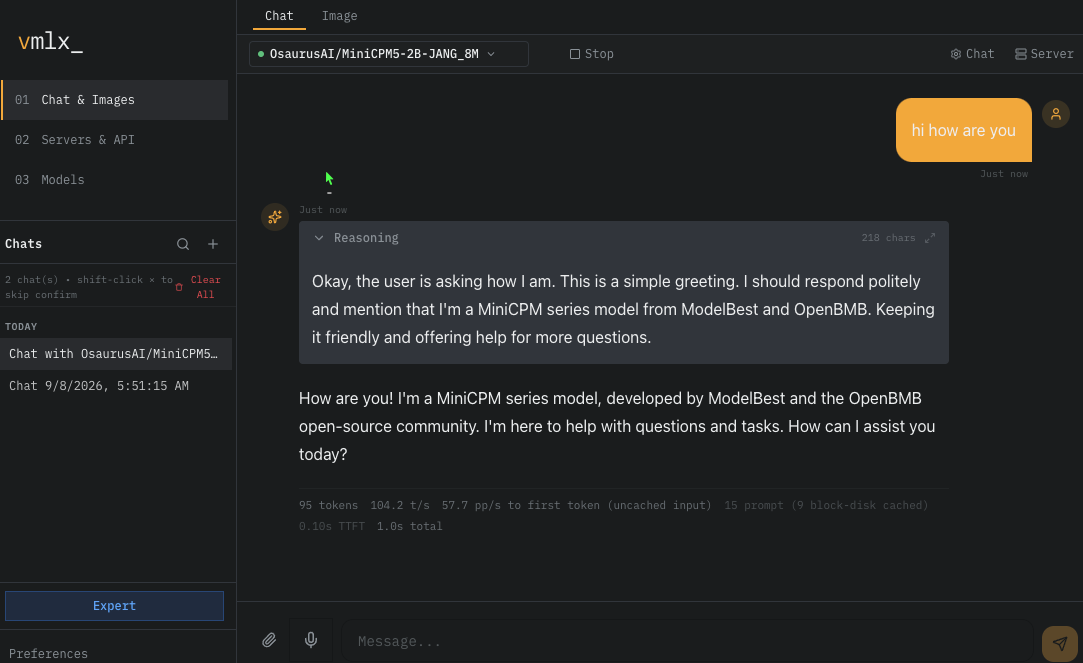
MLX Studio — 콘솔
응답 도중의 콘솔 — 추론 블록이 펼쳐진 상태와 토큰·처리량·프롬프트 속도·캐시 상태·첫 토큰까지의 시간을 보여주는 턴 푸터.
에이전틱 도구
20+
파일 입출력, 검색, 셸, git, 웹 — 설정 불필요
아키텍처
50+
Mamba·SSM 하이브리드 포함
이미지 모델
9
생성 6개, 편집 3개, 전부 로컬
비용
$0
구독도, API 키도, 계정도 없음
01

필요한 건 전부. 클라우드에는 아무것도.

열자마자 대화를 시작할 만큼 간단하고, 그 아래에 완전한 추론 스택을 돌릴 만큼 깊습니다 — KV 캐시 양자화, 프리픽스 캐싱, 스펙큘러티브 디코딩, 14개 도구 파서. 원하면 다 꺼내 쓰고, 원하지 않으면 보이지 않습니다.

01 스트리밍 채팅인라인 도구 호출 표시, 접을 수 있는 추론 블록, 이미지 미리보기, 실시간 상태가 포함된 멀티턴 대화. 모든 모델
02 에이전틱 코딩MCP를 기본 지원하는 20개 이상의 내장 도구. 모델이 직접 읽고, 쓰고, 검색하고, 실행합니다. 20개 도구
03 이미지 생성·편집생성은 Flux Schnell·Dev·Klein, 편집은 Qwen Image Edit·Flux Kontext·Flux Fill로 인페인팅과 리스타일링. 9개 모델
04 비전·멀티모달채팅에 이미지를 끌어다 놓으세요. 비전 모델이 로컬에서 분석하고, 클릭하면 확대됩니다. qwen vl
05 추론 블록DeepSeek R1, Qwen 3, GLM의 사고 과정을 접었다 폈다. 과정을 보거나 숨기세요. 4개 파서
06 음성모든 응답에 맥 기본 음성 합성으로 읽어주기. 손을 쓰지 않고 들을 수 있습니다. 내장
07 Anthropic·OpenAI APIOpenAI Chat·Responses와 함께 네이티브 Anthropic Messages 엔드포인트를 제공합니다. Claude Code, OpenClaw, Anthropic SDK가 그대로 연결되고, 원격 엔드포인트도 지정할 수 있습니다. 둘 다
08 모델 변환기앱 안에서 GGUF를 MLX로, JANG 혼합 정밀도 양자화 프로파일까지. 누군가 변환본을 올려주길 기다릴 필요가 없습니다. gguf → mlx
────────────────────────────────────────────────────────────────────────────────────────────────────────
02

20개 이상의 내장 도구. 설정은 없음.

네이티브 MCP 도구 호출이 기본으로 켜져 있습니다. 모델이 파일을 읽고, 코드를 검색하고, 명령을 실행하고, git 상태를 확인합니다 — 전부 로컬에서, 설치할 플러그인도 붙여 넣을 키도 없이.

File I/O

  • read_file
  • write_file
  • edit_file
  • list_dir
  • copy
  • move
  • delete

Code search

  • grep
  • glob

Shell

  • execute_command

Web

  • duckduckgo_search
  • brave_search
  • fetch_url

Git

  • git_status
  • git_diff
  • git_log
  • git_show

Utilities

  • clipboard_read
  • clipboard_write
  • current_datetime
────────────────────────────────────────────────────────────────────────────────────────────────────────
03

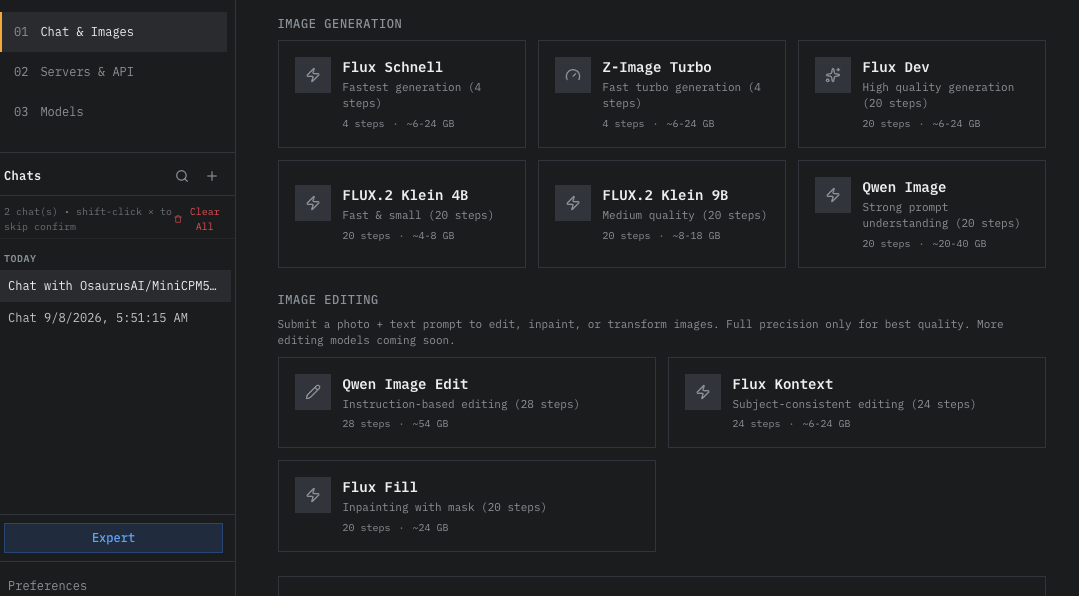
이미지를 내 기기에서 만들고 편집하세요

아홉 개 모델을 필요할 때 받아 Apple Silicon에서 실행합니다. 프롬프트만 주거나, 사진과 프롬프트를 함께 주어 인페인팅·변형·리스타일링하세요. 클라우드 API도 크레딧도 없습니다.

Flux Schnell
가장 빠른 생성 · 4스텝 · ~6-24 GB
Z-Image Turbo
빠른 터보 생성 · 4스텝 · ~6-24 GB
Flux Dev
고품질 · 20스텝 · ~6-24 GB
FLUX.2 Klein 4B
빠르고 작음 · 20스텝 · ~4-8 GB
FLUX.2 Klein 9B
중간 품질 · 20스텝 · ~8-18 GB
Qwen Image
프롬프트 이해력이 뛰어남 · 20스텝 · ~20-40 GB
Qwen Image Edit
지시 기반 편집 · 28스텝 · ~54 GB
Flux Kontext
피사체 일관 편집 · 24스텝 · ~6-24 GB
Flux Fill
마스크 인페인팅 · 20스텝 · ~24 GB
────────────────────────────────────────────────────────────────────────────────────────────────────────
04

그 아래에는 vMLX 엔진

MLX Studio는 앱입니다 — 채팅 창, 도구, 모델 브라우저. vMLX는 그것을 움직이는 추론 엔진이고, 오픈 소스입니다. LM Studio와 llama.cpp의 관계와 비슷하되, 양쪽 모두 우리가 만듭니다.

01 프리픽스 캐시대화에서 반복되는 부분은 한 번만 계산하고 재사용하므로, 긴 대화도 느려지지 않습니다. 레이어 1
02 페이지드 KV 캐시열려 있는 모든 대화가 메모리에 남습니다 — 전환해도 아무것도 밀려나지 않습니다. 레이어 2
03 캐시 양자화q4/q8로 실시간 캐시 메모리를 4~8배 줄여 아주 긴 컨텍스트가 들어갑니다. 저장된 프리픽스는 full precision을 유지합니다. 레이어 3
04 연속 배칭로드된 모델 하나에서 최대 256개 시퀀스를 동시에 처리해 여러 에이전트가 함께 씁니다. 레이어 4
05 영구 디스크 캐시앱을 다시 켜도 프롬프트 계산이 남아 있어, 차갑게가 아니라 따뜻하게 시작합니다. 레이어 5
첫 토큰까지 걸린 시간 — M3 Ultra 256GB · Llama 3.2 3B 4-bit · LM Studio 대비
컨텍스트MLX StudioLM Studio차이
2.5K 토큰짧은 프롬프트0.05 s0.49 s9.7×
10K 토큰실사용 컨텍스트0.08 s6.12 s76×
100K 토큰콜드 프롬프트 처리0.65 s131 s224×

M3 Ultra 256GB, Llama 3.2 3B 4-bit에서 LM Studio와 비교해 측정했습니다. 위 두 행은 첫 토큰까지의 시간이고, 마지막 행은 콜드 프롬프트 처리입니다. 디코딩 처리량은 컨텍스트 길이와 출력의 예측 가능성에 따라 달라지는 별개의 측정치라 하나의 숫자로 제시하지 않습니다.

────────────────────────────────────────────────────────────────────────────────────────────────────────
05

어떻게 생겼나

Apple Silicon에서 실행 중인 앱 화면입니다.

채팅 & 이미지
채팅 & 이미지 — 생성·편집 모델 선택기. 각 모델의 스텝 수와 메모리 사용량 표시.
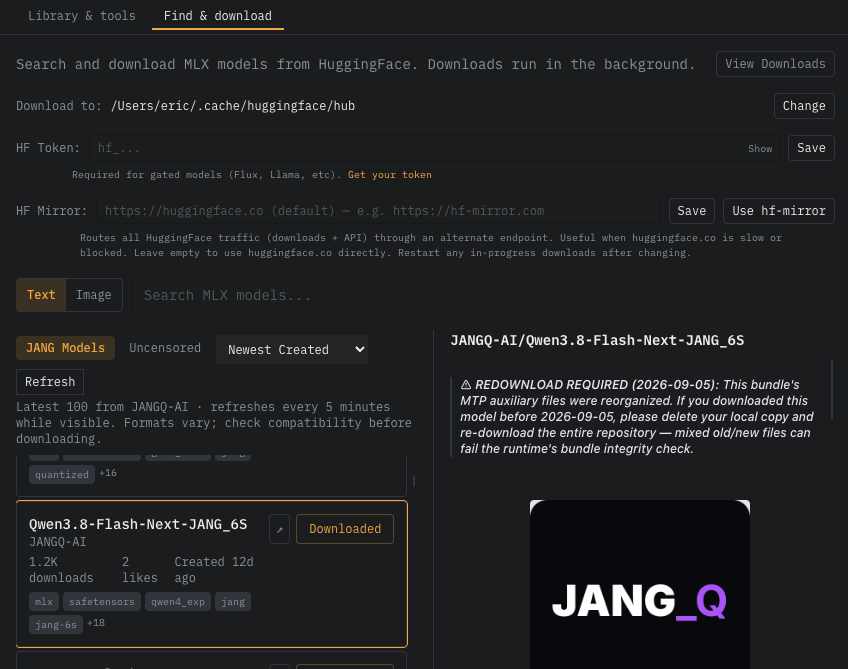
모델 — 검색·다운로드
모델 — Hugging Face에서 MLX 모델을 검색하고 백그라운드로 내려받기.
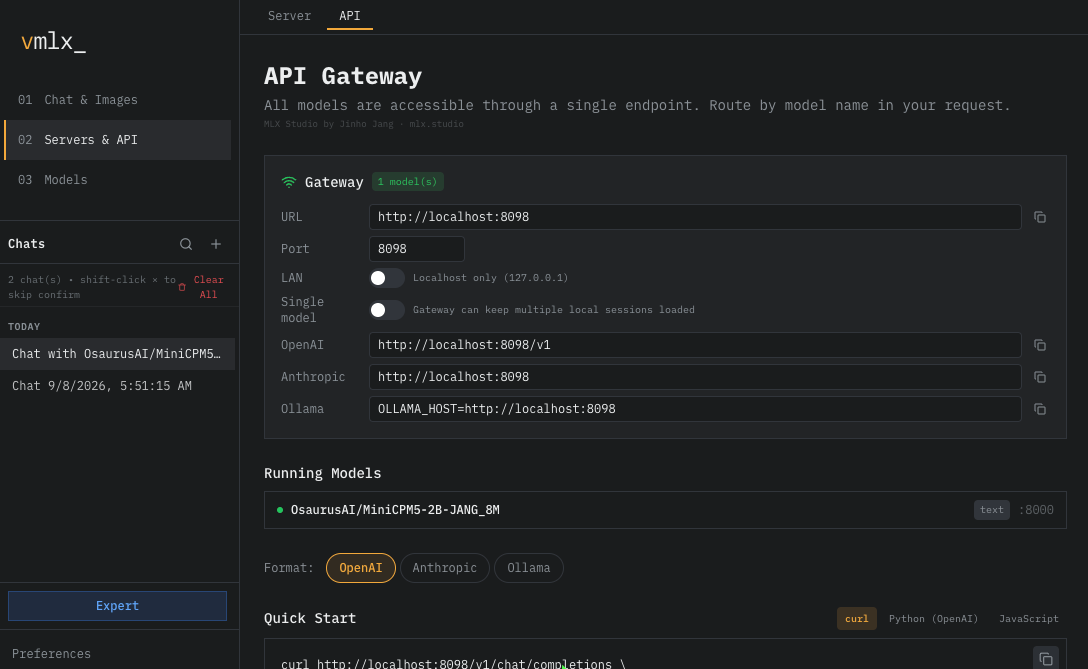
서버 & API — 게이트웨이
서버 & API — 로드된 모든 모델 앞의 단일 게이트웨이. OpenAI·Anthropic·Ollama를 지원.
────────────────────────────────────────────────────────────────────────────────────────────────────────
06

설치하기

앱을 받거나, 서버만 필요하다면 엔진만 설치하세요.

권장
# 다운로드 후 응용 프로그램으로 끌어다 놓고 실행
# 채팅, 도구, 이미지, 변환기,
# API 서버까지 하나에
엔진pip
$ pip install vmlx
$ vmlx serve mlx-community/Qwen3-8B-4bit
# OpenAI + Anthropic 호환
# http://127.0.0.1:8000
────────────────────────────────────────────────────────────────────────────────────────────────────────
07

자주 묻는 질문

MLX Studio가 뭔가요?
Apple Silicon에서 모델을 로컬로 실행하는, AI 채팅과 에이전틱 코딩을 위한 무료 macOS 앱입니다. 파일 편집·코드 검색·셸 실행·웹 검색을 위한 20개 이상의 내장 도구, 이미지 생성과 편집, 모델 변환기, API 서버가 들어 있고, 그 아래에서 vMLX 엔진이 돌아갑니다.
MLX Studio와 vMLX 엔진은 뭐가 다른가요?
MLX Studio는 앱입니다 — 채팅 UI, 에이전틱 도구, 모델 브라우저, 설정. vMLX는 그것을 움직이는 추론 백엔드입니다: 캐싱, 배칭, 모델 로딩, API 레이어. LM Studio와 llama.cpp의 관계와 비슷하되 양쪽이 같은 프로젝트입니다. 엔진은 오픈 소스이고 pip install vmlx로 따로 설치할 수 있습니다.
인터넷 연결이 필요한가요?
모델을 처음 받을 때만 필요합니다. 추론은 전부 로컬에서 실행되고, 클라우드 연결도 API 키도 없으며 데이터가 맥을 떠나지 않습니다.
어떤 맥이 필요한가요?
M1 이상의 Apple Silicon 맥, macOS 14.5 이상이면 됩니다. 통합 메모리 8GB가 최소이고 16GB 이상이면 여유롭습니다. 원격 엔드포인트 연결은 macOS 14+에서 동작합니다.
클라우드 API도 쓸 수 있나요?
네. OpenAI, Anthropic, Groq 또는 OpenAI 호환 엔드포인트에 연결할 수 있습니다. 에이전틱 도구는 모델이 로컬이든 원격이든 동일하게 동작합니다.
얼마인가요?
무료입니다. 영구 무료이고 구독도, 계정도, 유료 등급도 없습니다.