gratis · macOS · apple silicon
Todo aquello para lo que usas IA.
Nada de ello sale del Mac.
Chatea con cualquier modelo abierto, escribe código con 20 herramientas agénticas, genera y edita imágenes con Flux, convierte modelos entre formatos y sirve una API compatible con OpenAI o Anthropic a tus otras apps. Una sola app, funcionando enteramente en Apple Silicon. Sin claves de API, sin suscripción, sin subir nada.
Gratis para siempre · macOS 14.5+ · del M1 al M5 · 8 GB mínimo, 16 GB o más recomendado
MLX Studio — Consola
herramientas agénticas
20+
Archivos, búsqueda, shell, git, web — sin configurar
arquitecturas
50+
Incluidos híbridos Mamba y SSM
modelos de imagen
9
6 de generación, 3 de edición, todos locales
coste
$0
Sin suscripción, sin claves de API, sin cuenta
01
Todo lo que necesitas. Nada en la nube.
Lo bastante simple para abrirla y empezar a chatear, lo bastante profunda para ejecutar debajo una pila de inferencia completa — cuantización de caché KV, caché de prefijos, decodificación especulativa y 14 analizadores de herramientas, todo a mano si lo quieres e invisible si no.
01
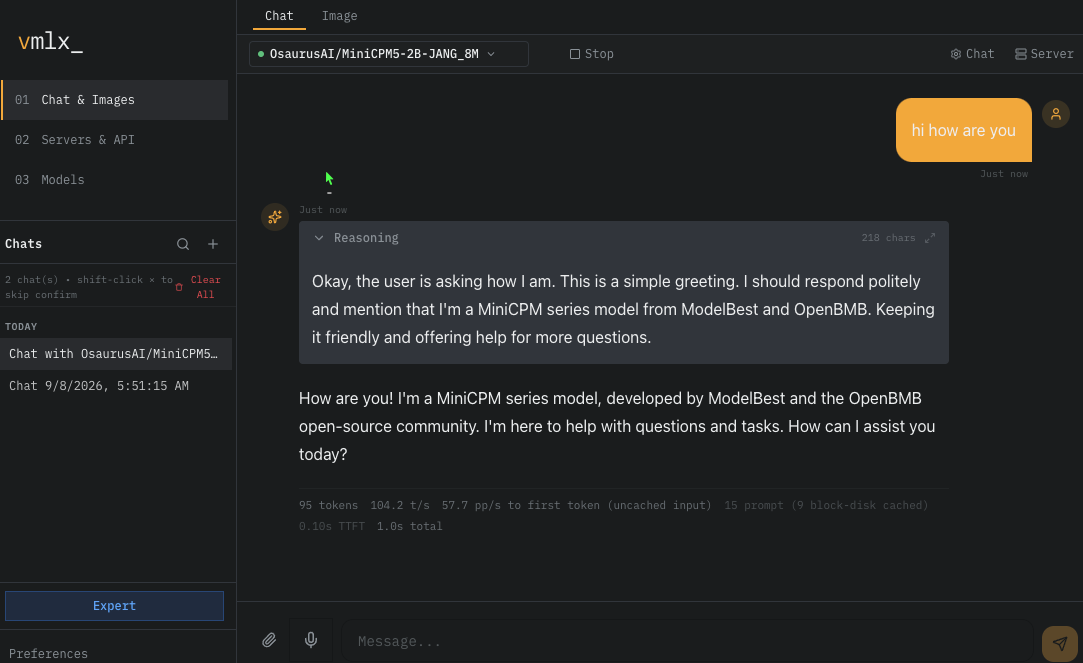
Chat en streamingConversaciones de varios turnos con marcas de llamadas a herramientas, bloques de razonamiento plegables, vistas previas de imágenes y estado en vivo.
cualquier modelo
02
Programación agénticaMás de 20 herramientas integradas con soporte nativo de MCP. Los modelos leen, escriben, buscan y ejecutan directamente en tu máquina.
20 herramientas
03
Generación y edición de imágenesFlux Schnell, Dev y Klein para generar; Qwen Image Edit, Flux Kontext y Flux Fill para retocar y cambiar de estilo.
9 modelos
04
Visión y multimodalArrastra una imagen al chat. Los modelos de visión la analizan localmente, con vista previa ampliable.
qwen vl
05
Bloques de razonamientoCadena de pensamiento plegable para DeepSeek R1, Qwen 3 y GLM. Mira el proceso o guárdalo.
4 analizadores
06
VozLectura en voz alta de cada respuesta con la síntesis de voz nativa del Mac. Salida sin manos.
integrado
07
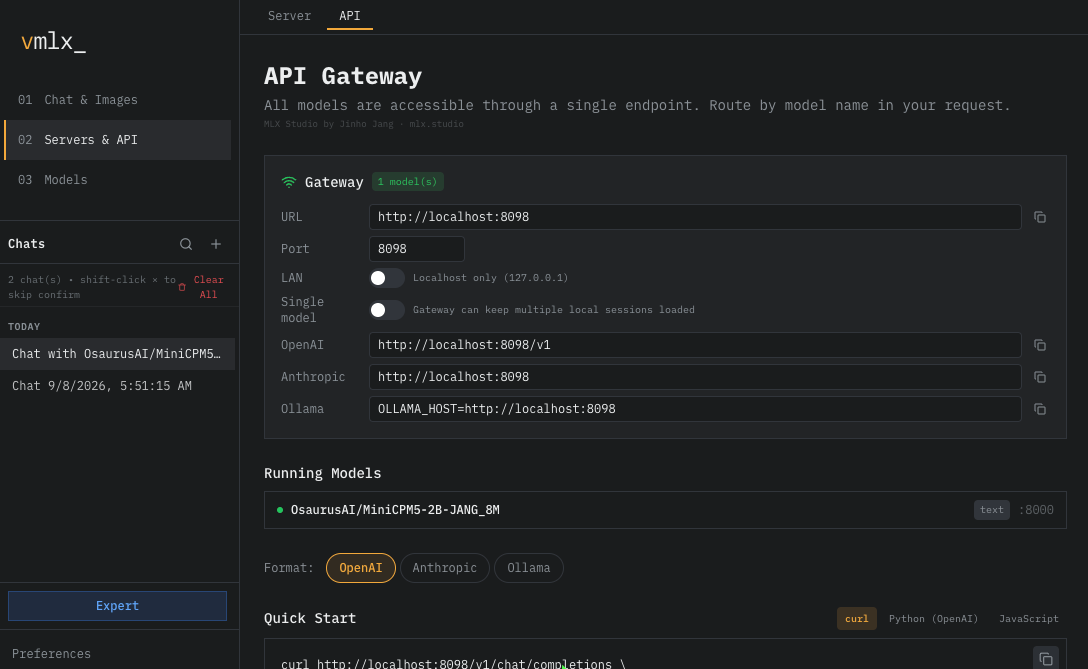
APIs de Anthropic y OpenAIUn endpoint nativo de Anthropic Messages junto a OpenAI Chat y Responses. Claude Code, OpenClaw y el SDK de Anthropic se conectan sin cambios, y también puedes apuntar a endpoints remotos.
ambas
08
Conversor de modelosDe GGUF a MLX dentro de la app, más perfiles de cuantización de precisión mixta JANG. Sin esperar a que otro publique una conversión.
gguf → mlx
────────────────────────────────────────────────────────────────────────────────────────────────────────
────────────────────────────────────────────────────────────────────────────────────────────────────────
03
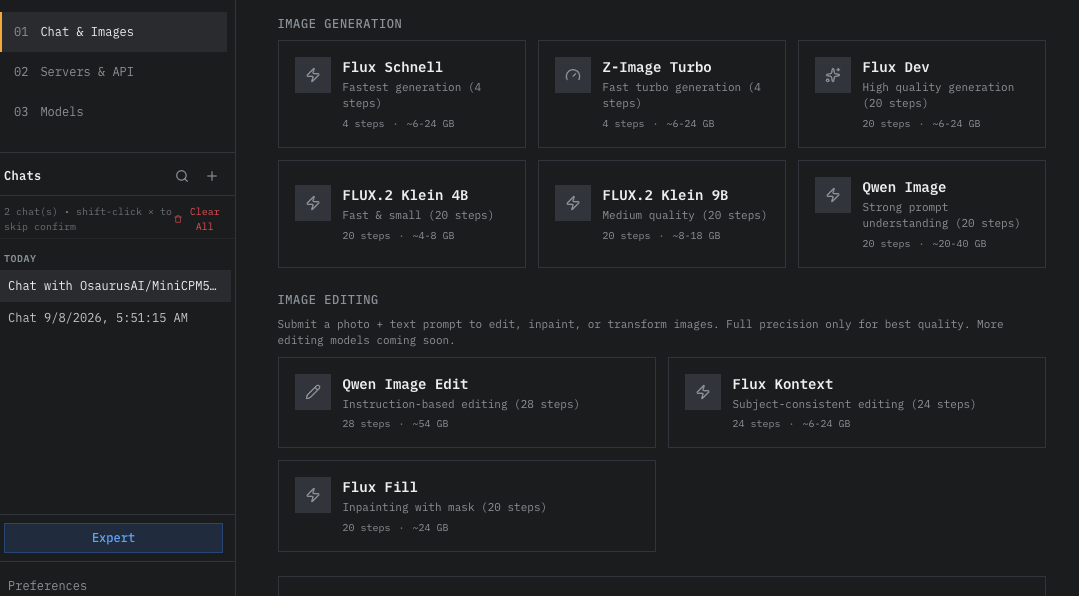
Genera y edita imágenes en tu propia máquina
Nueve modelos, descargados cuando hacen falta y ejecutados en Apple Silicon. Dale un prompt, o una foto y un prompt para retocar, transformar o cambiar el estilo. Sin API en la nube, sin créditos.
Flux Schnell
Generación más rápida · 4 pasos · ~6-24 GB
Z-Image Turbo
Turbo rápido · 4 pasos · ~6-24 GB
Flux Dev
Alta calidad · 20 pasos · ~6-24 GB
FLUX.2 Klein 4B
Rápido y pequeño · 20 pasos · ~4-8 GB
FLUX.2 Klein 9B
Calidad media · 20 pasos · ~8-18 GB
Qwen Image
Gran comprensión del prompt · 20 pasos · ~20-40 GB
Qwen Image Edit
Edición por instrucciones · 28 pasos · ~54 GB
Flux Kontext
Edición con sujeto consistente · 24 pasos · ~6-24 GB
Flux Fill
Retoque interior con máscara · 20 pasos · ~24 GB
────────────────────────────────────────────────────────────────────────────────────────────────────────
04
Debajo, el motor vMLX
MLX Studio es la app — la ventana de chat, las herramientas, el explorador de modelos. vMLX es el motor de inferencia que la mueve, y es de código abierto. La relación es más o menos la de LM Studio con llama.cpp, salvo que las dos mitades son nuestras.
01
Caché de prefijosLas partes repetidas de una conversación se calculan una vez y se reutilizan, así que un hilo largo no se vuelve más lento.
capa 1
02
Caché KV paginadaTodos los chats abiertos siguen en memoria — cambiar entre ellos no descarta nada.
capa 2
03
Cuantización de cachéq4/q8 reduce la memoria de caché en vivo entre 4 y 8 veces, que es lo que permite contextos muy largos. Los prefijos guardados mantienen la precisión completa.
capa 3
04
Batching continuoHasta 256 secuencias simultáneas sobre un único modelo cargado, de modo que varios agentes pueden compartirlo.
capa 4
05
Caché persistente en discoEl cálculo del prompt sobrevive a un reinicio de la app — vuelves a un arranque en caliente, no en frío.
capa 5
Tiempo hasta el primer token — M3 Ultra 256 GB · Llama 3.2 3B 4-bit · frente a LM Studio
| Contexto | MLX Studio | LM Studio | Diferencia |
|---|
| 2.5K tokensPrompt corto | 0.05 s | 0.49 s | 9.7× |
| 10K tokensContexto de trabajo | 0.08 s | 6.12 s | 76× |
| 100K tokensProcesado de prompt en frío | 0.65 s | 131 s | 224× |
Medido en un M3 Ultra con 256 GB, Llama 3.2 3B a 4 bits, frente a LM Studio. Las dos primeras filas son tiempo hasta el primer token; la última es procesado de prompt en frío. El rendimiento de decodificación es otra medida distinta, que depende de la longitud del contexto y de lo predecible que sea la salida, por eso no se resume en una sola cifra.
────────────────────────────────────────────────────────────────────────────────────────────────────────
05
Qué aspecto tiene
Pantallas de la app funcionando en Apple Silicon.
Chat e imágenes
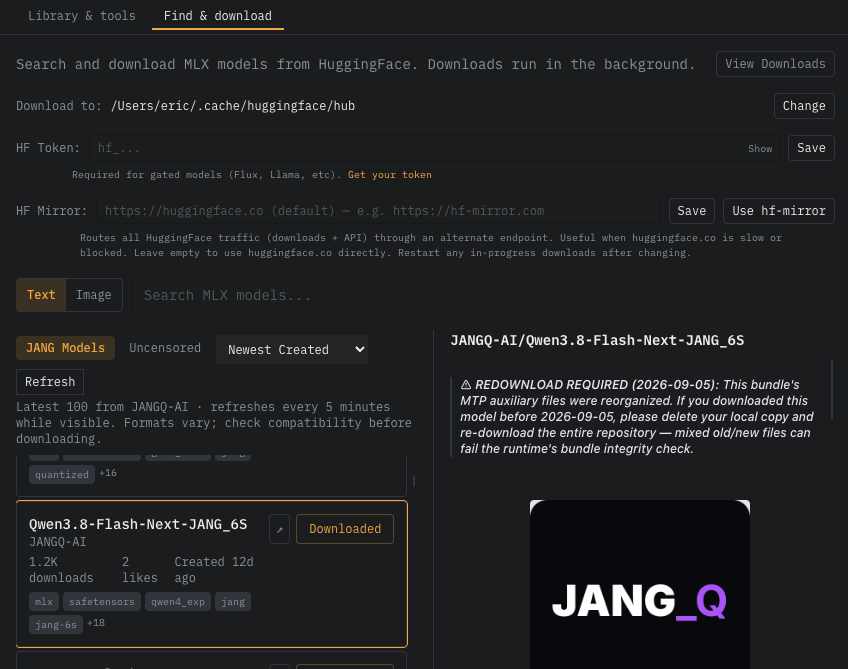
Modelos — buscar y descargar
Servidores y API — pasarela
────────────────────────────────────────────────────────────────────────────────────────────────────────
06
Consíguela
Descarga la app, o instala solo el motor si lo único que quieres es el servidor.
la apprecomendado
# descarga, arrastra a Aplicaciones y abre
# chat, herramientas, imágenes, conversor y
# el servidor de API, todo en uno
el motorpip
$ pip install vmlx
$ vmlx serve mlx-community/Qwen3-8B-4bit
# compatible con OpenAI + Anthropic en
# http://127.0.0.1:8000
────────────────────────────────────────────────────────────────────────────────────────────────────────
07
Preguntas
¿Qué es MLX Studio?
Una app gratuita de macOS para chat con IA y programación agéntica, que ejecuta modelos localmente en Apple Silicon. Incluye más de 20 herramientas integradas para editar archivos, buscar en código, ejecutar comandos y buscar en la web, además de generación y edición de imágenes, un conversor de modelos y un servidor de API, todo movido por el motor vMLX.
¿En qué se diferencia MLX Studio del motor vMLX?
MLX Studio es la app — la interfaz de chat, las herramientas agénticas, el explorador de modelos y los ajustes. vMLX es el backend de inferencia que la mueve: caché, batching, carga de modelos y la capa de API. Más o menos la relación que tiene LM Studio con llama.cpp, salvo que ambas mitades son el mismo proyecto. El motor es de código abierto y se instala por separado con pip install vmlx.
¿Necesita conexión a internet?
Solo para descargar los modelos la primera vez. Toda la inferencia es local, sin conexión a la nube, sin claves de API y sin que los datos salgan de tu Mac.
¿Qué Mac necesito?
Cualquier Mac con Apple Silicon — M1 o posterior — con macOS 14.5 o más reciente. 8 GB de memoria unificada es el mínimo; 16 GB o más va holgado. Conectar con endpoints remotos funciona desde macOS 14.
¿Puedo usar también APIs en la nube?
Sí. Puedes conectar con OpenAI, Anthropic, Groq o cualquier endpoint compatible con OpenAI. Las herramientas agénticas funcionan igual tanto si el modelo es local como remoto.
¿Cuánto cuesta?
Nada. Gratis para siempre, sin suscripción, sin cuenta y sin versión de pago.