無料 · macOS · apple silicon
AIでやることのすべてを。
Macの外には出しません。
どんなオープンモデルともチャットでき、20のエージェント機能でコードを書き、Fluxで画像を生成・編集し、モデル形式を変換し、他のアプリにOpenAI・Anthropic互換APIを提供します。アプリひとつで、すべてApple Silicon上。APIキーもサブスクもなく、アップロードされるものもありません。
ずっと無料 · macOS 14.5+ · M1〜M5 · 最小8GB、16GB以上推奨
MLX Studio — コンソール
エージェント機能
20+
ファイル入出力、検索、シェル、git、Web — 設定不要
アーキテクチャ
50+
Mamba・SSMハイブリッドを含む
費用
$0
サブスクもAPIキーもアカウントも不要
01
必要なものすべてを。クラウドには何も。
開いてすぐ話し始められるほど簡単で、その下では完全な推論スタックが動くほど深い — KVキャッシュ量子化、プレフィックスキャッシュ、投機的デコード、14種のツールパーサー。使いたければ全部出てきて、使わなければ見えません。
01
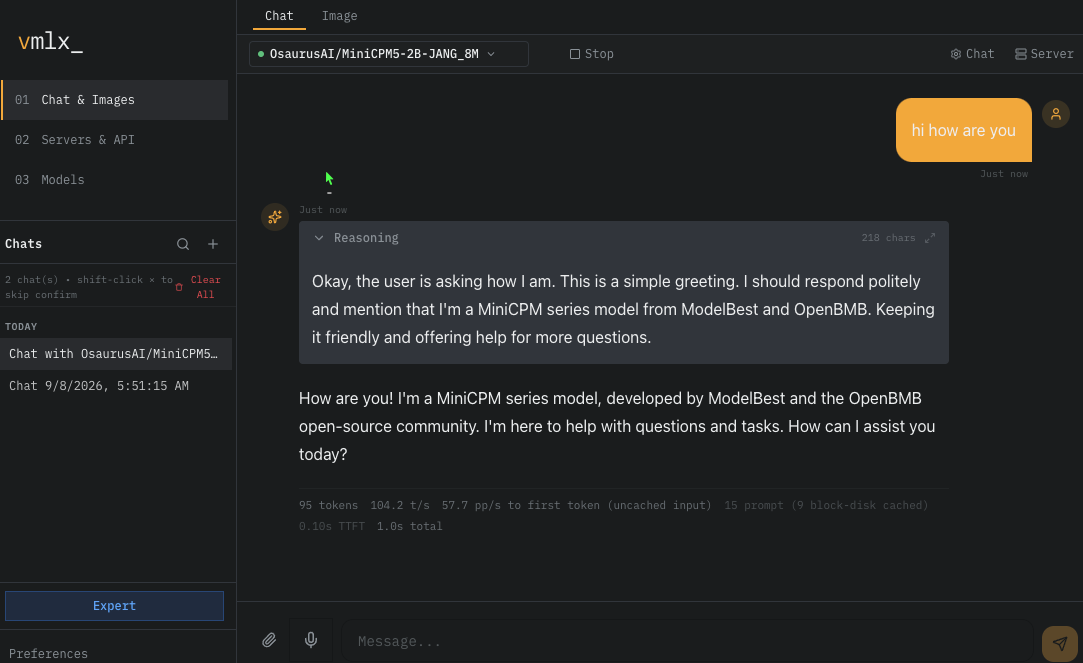
ストリーミングチャットインラインのツール呼び出し表示、折りたためる推論ブロック、画像プレビュー、リアルタイム状態を備えたマルチターン会話。
全モデル
02
エージェントコーディングMCPをネイティブ対応した20以上の内蔵ツール。モデルが直接読み、書き、検索し、実行します。
20ツール
03
画像の生成と編集生成はFlux Schnell・Dev・Klein、編集はQwen Image Edit・Flux Kontext・Flux Fillでインペイントやリスタイル。
9モデル
04
ビジョン・マルチモーダルチャットに画像をドラッグするだけ。ビジョンモデルがローカルで解析し、クリックで拡大できます。
qwen vl
05
推論ブロックDeepSeek R1、Qwen 3、GLMの思考過程を折りたたみ表示。過程を見るのも隠すのも自由です。
4パーサー
06
音声すべての応答をMac標準の音声合成で読み上げ。手を使わずに聞けます。
内蔵
07
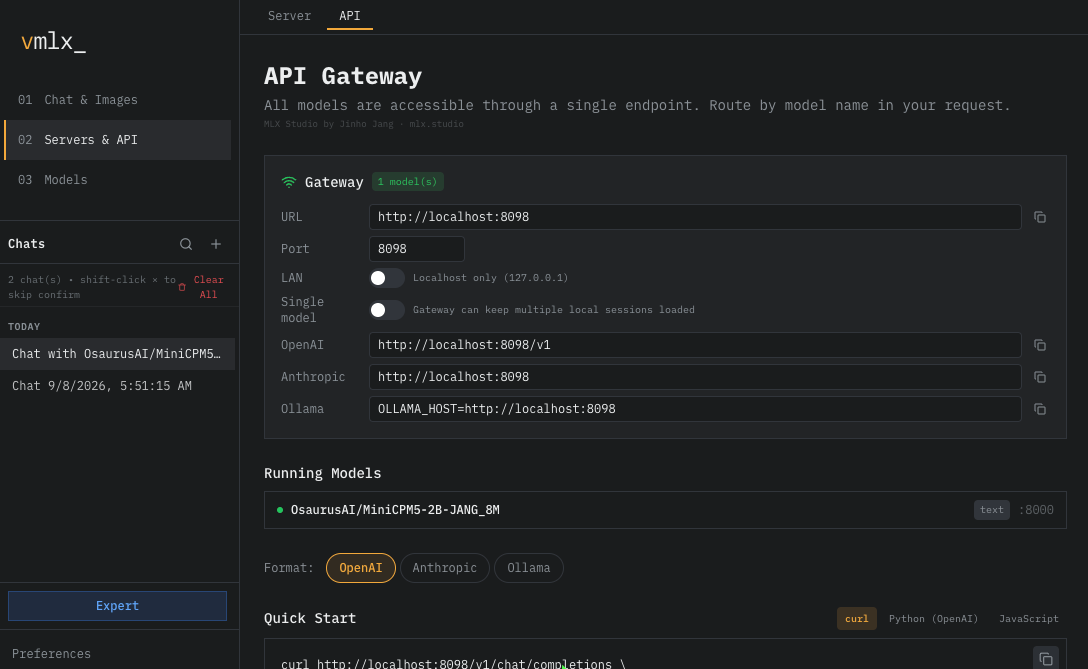
Anthropic・OpenAI APIOpenAI ChatとResponsesに加え、ネイティブのAnthropic Messagesエンドポイントを提供。Claude Code、OpenClaw、Anthropic SDKがそのまま接続でき、リモートエンドポイントも指定できます。
両対応
08
モデルコンバーターアプリ内でGGUFをMLXへ、さらにJANG混合精度量子化プロファイルも。誰かが変換版を公開するのを待つ必要はありません。
gguf → mlx
────────────────────────────────────────────────────────────────────────────────────────────────────────
────────────────────────────────────────────────────────────────────────────────────────────────────────
03
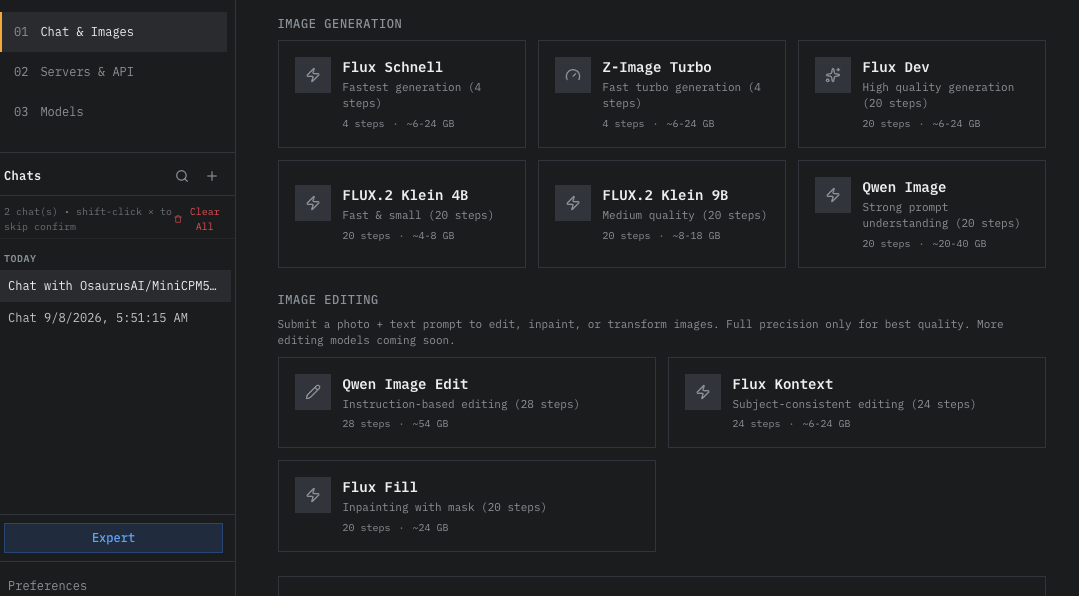
画像を自分のマシンで生成・編集する
9つのモデルを必要に応じてダウンロードし、Apple Silicon上で実行します。プロンプトだけ渡すか、写真とプロンプトを渡してインペイント・変換・リスタイルを。クラウドAPIもクレジットも不要です。
Flux Schnell
最速の生成 · 4ステップ · ~6-24 GB
Z-Image Turbo
高速ターボ生成 · 4ステップ · ~6-24 GB
Flux Dev
高品質 · 20ステップ · ~6-24 GB
FLUX.2 Klein 4B
高速で小さい · 20ステップ · ~4-8 GB
FLUX.2 Klein 9B
中品質 · 20ステップ · ~8-18 GB
Qwen Image
プロンプト理解が強い · 20ステップ · ~20-40 GB
Qwen Image Edit
指示ベースの編集 · 28ステップ · ~54 GB
Flux Kontext
被写体を保つ編集 · 24ステップ · ~6-24 GB
Flux Fill
マスクによるインペイント · 20ステップ · ~24 GB
────────────────────────────────────────────────────────────────────────────────────────────────────────
04
その下にあるのがvMLXエンジン
MLX Studioはアプリです — チャット画面、ツール、モデルブラウザ。vMLXはそれを動かす推論エンジンで、オープンソースです。LM Studioとllama.cppの関係に近く、ただし両方とも私たちのものです。
01
プレフィックスキャッシュ会話の繰り返し部分は一度だけ計算して再利用するので、長いスレッドでも遅くなりません。
レイヤー 1
02
ページドKVキャッシュ開いているチャットはすべて常駐します — 切り替えても何も破棄されません。
レイヤー 2
03
キャッシュ量子化q4/q8でライブキャッシュのメモリを4〜8分の1にし、非常に長い文脈が収まります。保存されたプレフィックスはfull precisionのままです。
レイヤー 3
04
連続バッチング読み込んだ1つのモデルで最大256並列。複数のエージェントで共有できます。
レイヤー 4
05
永続ディスクキャッシュアプリを再起動してもプロンプトの計算結果が残るので、コールドではなくウォームな状態から始まります。
レイヤー 5
最初のトークンまでの時間 — M3 Ultra 256GB · Llama 3.2 3B 4-bit · LM Studio比
| 文脈長 | MLX Studio | LM Studio | 差 |
|---|
| 2.5K トークン短いプロンプト | 0.05 s | 0.49 s | 9.7× |
| 10K トークン実用的な文脈 | 0.08 s | 6.12 s | 76× |
| 100K トークンコールドプロンプト処理 | 0.65 s | 131 s | 224× |
M3 Ultra 256GB、Llama 3.2 3B 4-bit で LM Studio と比較して測定しました。上二行は最初のトークンまでの時間、最後の行はコールドプロンプト処理です。デコード速度は文脈長と出力の予測しやすさに左右される別の指標なので、単一の数値にはしていません。
────────────────────────────────────────────────────────────────────────────────────────────────────────
05
見た目
Apple Silicon上で動作しているアプリの画面です。
チャット & 画像
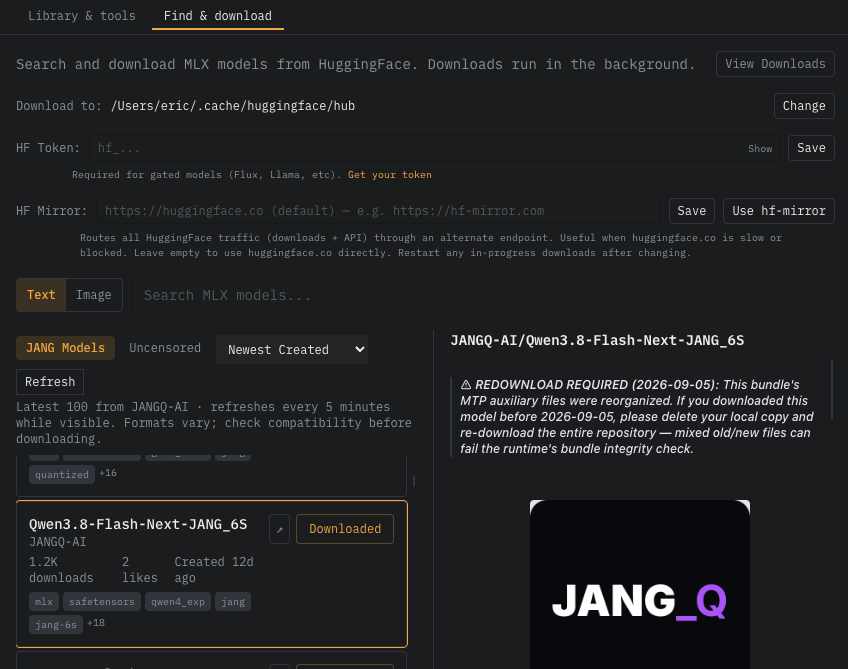
モデル — 検索とダウンロード
サーバー & API — ゲートウェイ
────────────────────────────────────────────────────────────────────────────────────────────────────────
06
入手する
アプリをダウンロードするか、サーバーだけ必要ならエンジンのみ導入してください。
アプリ推奨
# ダウンロードしてアプリケーションにドラッグし起動
# チャット、ツール、画像、コンバーター、
# APIサーバーまで一つに
エンジンpip
$ pip install vmlx
$ vmlx serve mlx-community/Qwen3-8B-4bit
# OpenAI + Anthropic 互換
# http://127.0.0.1:8000
────────────────────────────────────────────────────────────────────────────────────────────────────────
07
よくある質問
MLX Studioとは?
Apple Silicon上でモデルをローカル実行する、AIチャットとエージェントコーディングのための無料macOSアプリです。ファイル編集・コード検索・シェル実行・Web検索のための20以上の内蔵ツール、画像の生成と編集、モデルコンバーター、APIサーバーを備え、その下でvMLXエンジンが動いています。
MLX StudioとvMLXエンジンの違いは?
MLX Studioはアプリです — チャットUI、エージェント機能、モデルブラウザ、設定。vMLXはそれを動かす推論バックエンドで、キャッシュ、バッチング、モデル読み込み、API層を担います。LM Studioとllama.cppの関係に近いですが、両方が同じプロジェクトです。エンジンはオープンソースで、pip install vmlxで単体導入できます。
インターネット接続は必要ですか?
モデルを最初にダウンロードするときだけです。推論はすべてローカルで実行され、クラウド接続もAPIキーもなく、データがMacから出ることはありません。
どのMacが必要ですか?
M1以降のApple Silicon Mac、macOS 14.5以降です。ユニファイドメモリは8GBが最小、16GB以上が快適です。リモートエンドポイントへの接続はmacOS 14+で動作します。
クラウドAPIも使えますか?
はい。OpenAI、Anthropic、Groq、その他OpenAI互換のエンドポイントに接続できます。エージェント機能はモデルがローカルでもリモートでも同じように動きます。
料金は?
無料です。ずっと無料で、サブスクもアカウントも有料プランもありません。